
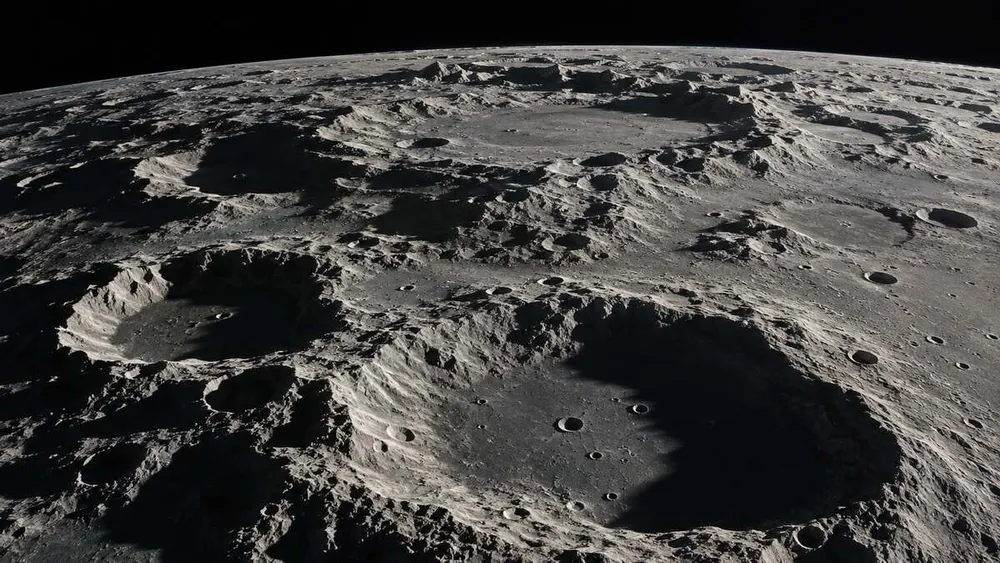
Un nouveau modèle d'intelligence artificielle open source, entraîné sur près de 2 millions d'images lunaires, permet de cartographier les cratères, d'identifier les terrains volcaniques inhabituels et d'estimer les zones de stabilité de la glace près des pôles lunaires, ont annoncé jeudi la NASA et IBM. Le modèle NASA-IBM Lunar Foundation combine plus d'un million d'images haute résolution prises par des caméras avec près de 964 000 images multispectrales, offrant ainsi aux chercheurs une base technique réutilisable pour différents types d'analyses lunaires, au lieu d'un modèle distinct pour chaque tâche.
Le communiqué public de la NASA décrit ce système comme l'un des premiers modèles de base open source conçus spécifiquement pour l'étude de la Lune. Ses pondérations, ses modèles en aval, ses données de référence et son code sont disponibles pour des tests externes. Cette ouverture est essentielle, car la valeur du modèle dépendra non seulement des performances de référence rapportées par ses créateurs, mais aussi de la capacité des chercheurs indépendants à reproduire les résultats et à adapter le système de manière fiable à différents instruments, conditions d'éclairage et questions scientifiques.
Lors des premières évaluations, le modèle a égalé, voire surpassé, plusieurs performances de référence en matière de cartographie des cratères et de segmentation des mers lunaires irrégulières, tout en démontrant un avantage certain dans l'estimation de la stabilité de la glace polaire. Selon Reuters. Ces résultats sont prometteurs, mais ils évaluent les performances sur des tâches de recherche définies, et non une décision d'atterrissage définitive ni la présence d'eau récupérable.
Un modèle général pour les données lunaires
Les modèles de base sont entraînés sur de vastes ensembles de données afin que leurs représentations apprises puissent être adaptées à de nombreuses tâches en aval avec des quantités relativement faibles de données étiquetées. Dans le domaine de la recherche lunaire, cette approche permet de réduire la nécessité pour les scientifiques de concevoir et d'entraîner un modèle spécialisé à chaque fois qu'ils souhaitent compter les cratères, segmenter une formation géologique ou comparer les variations de surface. Le nouveau modèle sert de structure visuelle commune, pouvant être affinée pour un problème scientifique spécifique.
Les données d'entraînement proviennent principalement de la sonde Lunar Reconnaissance Orbiter (LRO) de la NASA, qui étudie la Lune depuis 2009. Les recueillies comprennent une cartographie quasi globale de la surface lunaire ainsi que des mesures de température, de composition et de rayonnement. La NASA indique que le volume de données de LRO dépasse celui de toutes ses autres missions planétaires réunies, ce qui rend ces archives précieuses mais difficiles à examiner de manière exhaustive par une analyse manuelle.
Le modèle intègre également des images et des données topographiques issues des missions GRIL (Gravity Recovery and Interior Laboratory) et LPL (Lunar Prospector) de la NASA, ainsi que de la mission japonaise SEE (Selenological and Engineering Explorer). La combinaison de ces modalités permet au système de reconnaître des relations difficiles à extraire d'un seul type d'image. Les photographies haute résolution révèlent les détails fins de la surface, tandis que les observations multispectrales et les couches topographiques fournissent des informations sur la composition, l'altitude et l'éclairage.
Trois tests ayant une valeur pratique
La détection des cratères est l'application la plus intuitive. Les scientifiques utilisent le nombre, la taille et la répartition des cratères d'impact pour estimer l'âge relatif des surfaces lunaires et reconstituer des pans de l'histoire du système solaire. L'automatisation de la détection dans de vastes archives peut accélérer ce travail et faciliter la comparaison cohérente des régions, même si l'intervention humaine reste essentielle lorsque des ombres, des bords qui se chevauchent ou des images à faible résolution créent des ambiguïtés.
Une seconde tâche concerne les mares lunaires irrégulières, de petites formations volcaniques qui semblent plus jeunes que la majeure partie du terrain environnant. Leur cartographie aide les chercheurs à tester les hypothèses relatives à l'évolution volcanique et thermique de la Lune. Le modèle permet de segmenter ces formations plus rapidement qu'une recherche manuelle, ce qui permet aux scientifiques de consacrer davantage de temps à l'interprétation de leur distribution et à la détermination des zones qui méritent une observation plus approfondie.
La troisième application, l'étude des gisements de glace polaire, présente la pertinence opérationnelle la plus évidente. Les cratères constamment plongés dans l'ombre peuvent rester suffisamment froids pour que la glace s'y conserve pendant des milliards d'années. L'étude de la NASA sur l'eau lunaire explique que les dépôts de glace pourraient révéler comment l'eau a atteint la Lune et s'y est déplacée. Dans le cadre d'un futur programme d'exploration, l'eau accessible pourrait également alimenter les réserves potables, permettre la production d'oxygène ou de propergol, mais les cartes de prospection identifient les emplacements probables sans pour autant vérifier la quantité, la pureté ou l'exploitabilité d'un gisement.
L'accès libre élargit le test
La NASA et IBM ont publié la collection de modèles sur Hugging Face, incluant des versions dérivées distinctes pour la détection des cratères, l'évaluation du potentiel glaciaire et la segmentation des zones irrégulières des mers lunaires. Cette publication permet aux universités et aux petits groupes de recherche d'accéder à un système dont l'entraînement serait coûteux en interne. Elle crée également une base de référence commune pour la comparaison de nouvelles approches, évitant ainsi à chaque laboratoire de devoir construire un point de départ différent.
Le dépôt de code associé fournit des outils de réglage fin et d'inférence, l'intégration avec le framework open source TerraTorch et des configurations pour les tâches en aval. La NASA a également publié des jeux de données et des collections de référence prêts pour l'apprentissage automatique. Le dépôt précise que le code de pré-entraînement n'est pas inclus ; les chercheurs devront tenir compte de cette limitation pour évaluer la reproductibilité du processus d'entraînement initial.
L'ouverture des poids et du code ne supprime pas automatiquement les autres obstacles. L'exécution d'un modèle de vision complexe exige toujours des ressources de calcul, une expertise technique et une gestion rigoureuse des données. Les chercheurs doivent également examiner si les jeux de données de référence présentent des biais géographiques ou liés aux capteurs, si les images d'entraînement se chevauchent avec les images d'évaluation et comment les erreurs du modèle varient selon les régions soumises à un éclairage extrême ou irrégulier.
Pourquoi l'imagerie lunaire est difficile
La Lune pose des problèmes inhabituels en matière de vision par ordinateur. En l'absence quasi totale d'atmosphère, l'apparence de sa surface est fortement influencée par l'angle d'incidence du rayonnement solaire, et près des pôles, un même relief peut présenter des différences considérables d'une observation à l'autre. Des ombres profondes peuvent masquer le fond des cratères, tandis que des pentes éclairées peuvent atténuer la texture visible. La NASA souligne que les variations d'éclairage peuvent affecter la visibilité des petits cratères, même lorsque le terrain sous-jacent reste inchangé.
La résolution ajoute une contrainte supplémentaire. La base de données d'entraînement combine des images dont la résolution spatiale varie d'environ 1 mètre à 100 mètres par pixel ; ainsi, une couche de données peut révéler une structure à l'échelle d'un bloc erratique tandis qu'une autre ne capture que son contexte géologique plus large. Un modèle doit apprendre les corrélations pertinentes entre ces échelles sans considérer chaque différence comme un changement physique. Ses prédictions doivent donc être perçues comme des outils permettant de prioriser l'analyse d'experts, et non comme des substituts à l'étalonnage des instruments ou au jugement géologique.
Le rapport technique et les analyses comparatives qui l'accompagnent permettront aux spécialistes d'examiner l'architecture, les choix d'entraînement et les performances spécifiques à chaque tâche. La preuve la plus importante proviendra d'une évaluation indépendante sur des données non sélectionnées par les développeurs du modèle, notamment des observations d'autres missions et des images nouvellement acquises. Une amélioration de 23 % sur une analyse comparative peut être significative sans pour autant impliquer le même gain pour chaque région lunaire ou objectif scientifique.
L'IA devient une infrastructure scientifique
Le modèle lunaire s'inscrit dans un effort conjoint plus vaste de la NASA et d'IBM visant à développer des systèmes d'IA réutilisables pour la science. Les précédents modèles Prithvi ont traité de l'observation de la Terre, de la météorologie, des inondations, des cultures et des ouragans, tandis qu'un modèle solaire a été développé pour la prévision météorologique spatiale. La stratégie de la NASA en matière d'IA conçoit ces systèmes comme un moyen d'exploiter davantage les vastes ensembles de données publiques, dont la taille croît plus vite que la capacité des chercheurs à les analyser manuellement.
Cette approche peut transformer l'économie des logiciels scientifiques. La formation d'un modèle largement utilisable et sa diffusion ouverte permettent à de nombreuses équipes de partager les coûts initiaux élevés, puis de consacrer leurs ressources à la validation et aux applications spécialisées. Elle peut également améliorer la comparabilité des études si les chercheurs rapportent leurs résultats par rapport aux mêmes critères de référence. En contrepartie, un modèle de base largement adopté risque de propager ses lacunes à de nombreux projets, rendant la documentation et les tests indépendants indispensables.
Le contexte immédiat de la mission est le programme Artemis, qui vise à acquérir de l'expérience en vue d'une exploration lunaire prolongée et de futures missions vers Mars. Des cartes plus précises permettraient de restreindre les zones d'atterrissage potentielles, d'identifier les dangers du terrain et de prioriser les sites pour des mesures directes des ressources. Toutefois, le modèle ne choisit pas un site d'atterrissage de manière unilatérale ; les contraintes techniques, les communications, l'éclairage, les objectifs scientifiques et les observations directes restent autant d'éléments pris en compte dans cette décision.
Ce que le communiqué établit
Le communiqué conjoint de la NASA et d'IBM démontre qu'un système pré-entraîné unique peut être performant sur plusieurs tâches de cartographie lunaire et que ses créateurs mettent à disposition des ressources essentielles pour analyse. Il ne prouve cependant pas que chaque prédiction est exacte, que la glace suspectée peut être extraite ou que l'analyse automatisée peut remplacer les planétologues. Ces distinctions sont particulièrement importantes lorsqu'un résultat d'IA influence des missions coûteuses ou la planification de missions critiques pour la sécurité.
La prochaine étape permettra de vérifier si le modèle devient une plateforme de recherche pérenne plutôt qu'une simple démonstration. Son adoption par des équipes indépendantes, ses performances sur de nouvelles données de mission, la transparence des rapports d'échec et la réduction mesurable du temps d'analyse apporteront des preuves plus solides de sa valeur opérationnelle. Pour l'heure, la NASA et IBM ont abaissé les barrières techniques à l'application de la vision par ordinateur avancée à la Lune et ouvert le système à la communauté scientifique, qui doit déterminer l'étendue de ses avantages.











