
Microsoft prévoit de déployer à grande échelle son nouveau système d'intelligence artificielle Maia 300 dès 2027, avec potentiellement plus d'un million d'accélérateurs personnalisés. L'entreprise fera ainsi de ses propres puces le moteur principal de l'inférence IA pour l'ensemble de ses produits et services. Selon Reuters, ce déploiement à grande échelle transférerait une part significative de la puissance de calcul IA de Microsoft des processeurs graphiques classiques vers du matériel conçu spécifiquement pour ses charges de travail.
Lundi, Microsoft a annoncé qu'un rack Maia 300 à 96 accélérateurs devrait fournir 40 % de jetons supplémentaires par mégawatt par rapport aux « systèmes GPU de pointe » et jusqu'à sept fois le débit de jetons à l'échelle d'un rack de son prédécesseur, le Maia 200. Il s'agit de projections de Microsoft, et non de résultats de tests indépendants : l'entreprise n'a pas précisé le système concurrent utilisé pour la comparaison de 40 %, et le déploiement en production ne débutera pas avant l'année prochaine.
Cette annonce est importante car l'inférence — le travail consistant à exécuter un modèle entraîné pour répondre à des questions, générer du code ou exécuter une séquence de tâches — devient le principal poste de dépenses récurrentes de l'IA commerciale. En contrôlant une plus grande partie de ce matériel, Microsoft cherche à optimiser la rentabilité de Copilot, GitHub, Foundry et de ses propres modèles, tout en réduisant sa dépendance aux accélérateurs Nvidia et AMD.
Un système construit autour de l'inférence
Le Maia 300 n'est pas présenté comme une simple réplique d'un GPU classique. La documentation produit décrit une conception axée sur l'inférence pour les contextes longs, les réponses conversationnelles rapides et les tâches d'agents complexes et soutenues. Huit modules de mémoire HBM4 à large bande passante offrent une capacité de 288 gigaoctets et une bande passante maximale de 18 téraoctets par seconde pour chaque accélérateur, le tout dans une enveloppe thermique de 950 watts.
Cette conception répartit les fonctions de calcul, de contrôle de la mémoire et d'entrée/sortie dans des chiplets. Les puces de calcul utilisent le procédé N2P de Taiwan Semiconductor Manufacturing Co., tandis que les autres composants peuvent être fabriqués selon les besoins en bande passante, connectivité ou coût. Ce partitionnement permet à Microsoft de réserver ses puces les plus performantes aux tâches pour lesquelles elle anticipe le gain d'efficacité le plus important.
Le déplacement des données est l'objectif principal de cette conception. la documentation technique , la puce utilise un flux de données piloté par logiciel et une organisation mémoire non uniforme afin de maintenir les informations à proximité des processeurs qui en ont besoin. Des formats de moindre précision réduisent encore le nombre d'octets transférés pour chaque jeton généré. Cette approche vise à résoudre un problème courant de l'inférence : fournir suffisamment rapidement aux unités de calcul les paramètres du modèle et le contexte enregistré pour les maintenir occupées.
Les racks deviennent l'unité de compétition
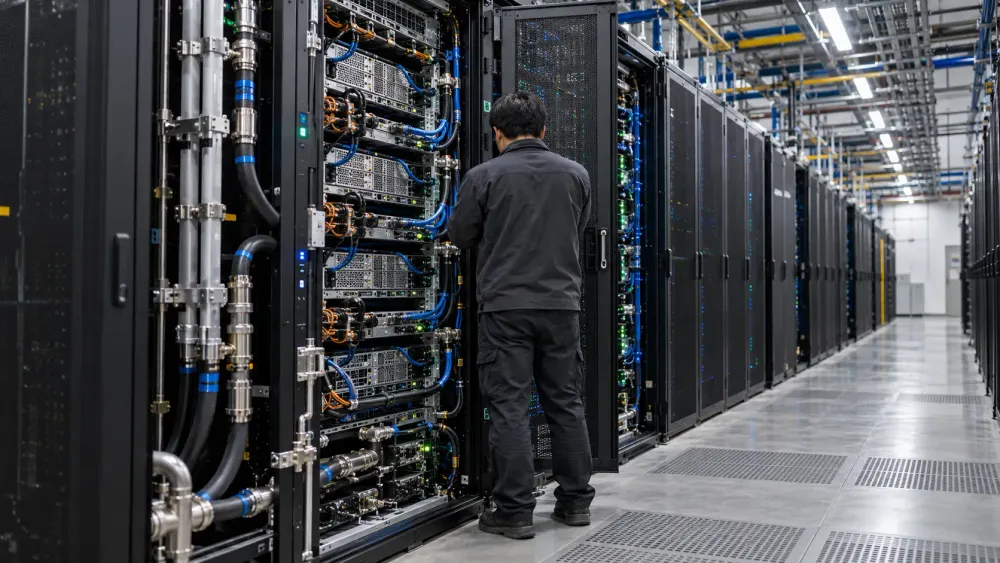
Chaque rack Maia 300 combine 96 accélérateurs répartis sur 24 plateaux à refroidissement liquide et consomme jusqu'à 167 kilowatts. Le rack complet contient 27,6 téraoctets de mémoire à large bande passante et offre une bande passante mémoire agrégée de 1,7 pétaoctet par seconde. Microsoft indique que le refroidissement liquide élimine plus de 80 % de la charge thermique du rack, tandis que le refroidissement par air classique convient aux composants moins gourmands en énergie.
Le réseau est tout aussi important. Un rack forme un pod, et jusqu'à 128 racks peuvent être reliés pour former un « superpod » de 12 288 accélérateurs. Microsoft utilise un protocole de transport Ethernet et un modèle de communication commun à tous les racks, permettant ainsi aux tâches importantes de s'exécuter sur plusieurs matériels sans que chaque transfert ne transite par un système hôte distinct. De ce fait, Maia 300 est autant une architecture de centre de données qu'une puce.
La puissance de 167 kilowatts est supérieure aux 142 kilowatts environ cités par Reuters pour un rack Nvidia GB300 de 72 GPU. L'argument de Microsoft repose sur le rendement énergétique, et non sur une consommation moindre du rack. Cette distinction est cruciale face aux contraintes des réseaux électriques pour les fournisseurs d'énergie et les exploitants de centres de données : une infrastructure plus dense n'est rentable que si le gain de puissance de calcul supplémentaire, dans le cadre d'une allocation énergétique fixe, compense la charge accrue de chaque rack.
Microsoft cherche à maîtriser les coûts récurrents de l'IA
Microsoft utilise déjà Maia 200 en production pour Copilot et le développement de ses modèles internes ; GitHub Copilot et Microsoft Foundry devraient suivre. Selon The Verge , Maia 300 est destiné à devenir le système d'inférence principal des services Microsoft, un rôle bien plus étendu qu'un simple programme d'accélération interne.
Ce calendrier reflète à la fois la demande et les pressions sur les dépenses. Lors de sa dernière conférence téléphonique sur les résultats, Microsoft a annoncé 41 milliards de dollars de dépenses d'investissement trimestrielles, dont environ les deux tiers consacrés à des actifs à durée de vie plus courte, principalement des processeurs et des cartes graphiques. L'entreprise prévoit environ 175 milliards de dollars de dépenses d'investissement pour l'année civile 2026 après une reclassification comptable d'un contrat de location, tandis que la demande pour Azure continue de dépasser les capacités disponibles.
L'utilisation de puces personnalisées n'élimine pas les fournisseurs externes. Microsoft propose toujours une plateforme Azure hétérogène et continue d'acquérir d'importants volumes de GPU. Sa stratégie consiste à réserver le matériel acheté aux cas où la flexibilité ou la compatibilité sont essentielles, tout en orientant les inférences internes prévisibles et à volume élevé vers Maia. En cas de forte utilisation, la maîtrise des logiciels, du réseau et des puces permet de réduire les coûts par jeton et de limiter la dépendance à un seul fournisseur d'accélérateurs.
Ces affirmations nécessitent encore des preuves concrètes
Les chiffres les plus importants restent prospectifs. Microsoft n'a pas publié les résultats détaillés par charge de travail, les coûts d'acquisition, les taux de défaillance ni les comparaisons auditées avec les systèmes concurrents nommément désignés. Le débit sept fois supérieur à celui du Maia 200 intègre également plusieurs améliorations, notamment deux fois plus d'accélérateurs par rack, une bande passante accrue, de nouveaux formats de précision et une enveloppe thermique plus performante ; il ne s'agit pas d'une simple mesure de performance entre puces.
Le déploiement à l'échelle du million de puces introduit également des risques liés à la fabrication, à l'approvisionnement en mémoire, au réseau et au refroidissement. La capacité de traitement avancée de TSMC et son approvisionnement en HBM4 influenceront la rapidité avec laquelle Microsoft pourra construire des systèmes, tandis que la prise en charge logicielle déterminera l'efficacité des modèles sur la nouvelle architecture. Une conception solide sur le papier peut néanmoins présenter des limitations dues à une faible utilisation, à des surcharges de planification ou à des outils encore immatures.
Ce que le déploiement permettra de tester
Maia 300 marque un tournant stratégique : l’entreprise passe de l’expérimentation d’accélérateurs personnalisés à leur intégration au cœur de son infrastructure. Son déploiement en 2027 permettra de vérifier si Microsoft peut traduire la maîtrise de l’architecture en réductions mesurables des coûts et de la consommation d’énergie par réponse d’IA utile, sans pour autant limiter le choix des modèles ni la fiabilité du service.
Les preuves les plus concluantes apparaîtront après le lancement de la production : taux d’utilisation, disponibilité pour les clients, données de performance comparables et part du trafic d’inférence de Microsoft transférée vers Maia. Pour l’heure, cette annonce définit l’échelle prévue et l’orientation technique. Elle ne démontre pas encore le gain d’efficacité que Microsoft affirme justifier cette échelle.











